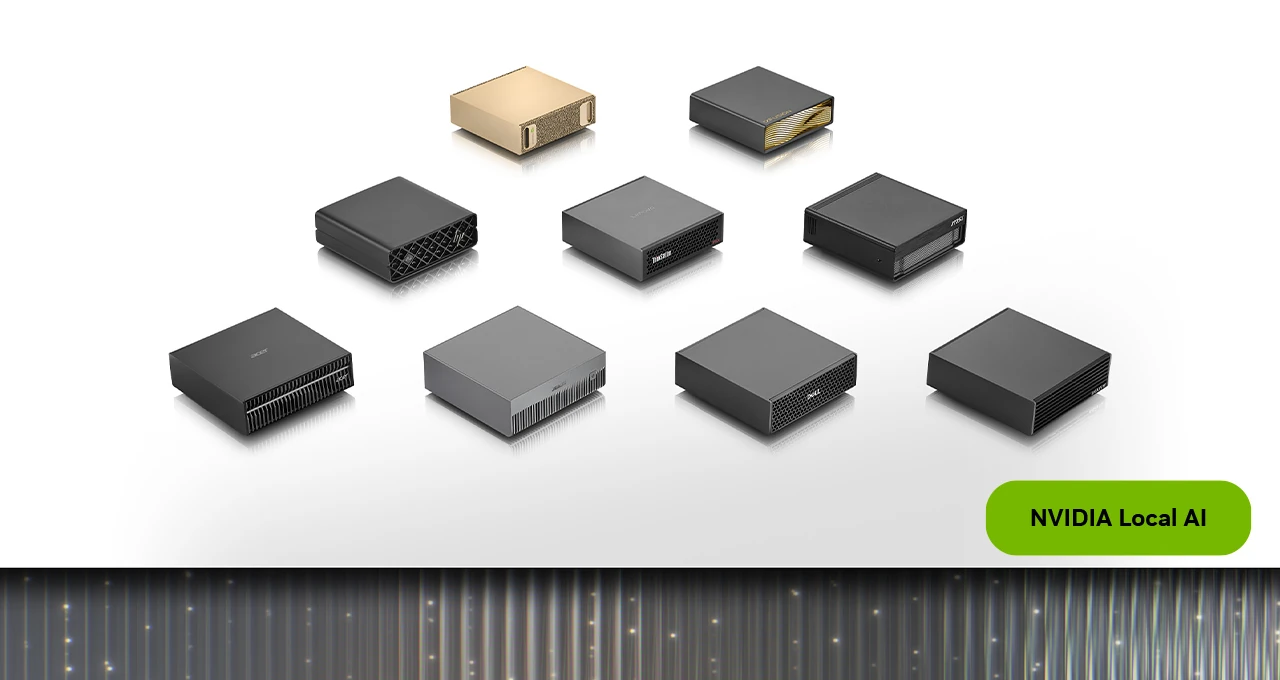
Nvidia ha declinato il suo mini-supercomputer DGX Spark nella versione 64 GB a $4.999 e propone di collegare due unità per raggiungere i 128 GB di memoria aggregata. L'offerta rende l'ecosistema GB10 più accessibile rispetto al modello da 128 GB, ma la parola "accessibile" rimane relativa: questa macchina è destinata a team che valorizzano la riservatezza e il prototipaggio locale, non a un pubblico generale alla ricerca di un PC IA.
Nvidia presenta il nuovo DGX Spark 64 Go come una porta d'ingresso per lo sviluppo locale di modelli di intelligenza artificiale. La macchina mantiene il formato compatto e l'architettura GB10 della famiglia, ma riduce la memoria unificata rispetto alla versione da 128 GB. Il prezzo annuncia di $4.999, con disponibilità a partire dal 23 ottobre tramite partner, conferma che si tratta uno strumento professionale specializzato piuttosto che un mini-PC convenzionale.
Memoria e Capacità: L'Elemento Centrale
Nel contesto dell'IA, la memoria è il dato centrale. Per eseguire un modello localmente, la capacità disponibile determina spesso ciò che può essere caricato prima ancora della potenza di calcolo. Nvidia indica che un DGX Spark 64 Go è in grado di supportare modelli fino a circa 100 miliardi di parametri, a seconda del formato e della quantizzazione. Questo limite non significa che tutti questi modelli saranno rapidi né che l'intera memoria rimarrà libera per il contesto e gli strumenti; si tratta invece di un ordine di grandezza utile per il prototipaggio.
L'ingegno chiave evidenziato da Nvidia consiste nel collegare due unità tramite l'interfaccia ConnectX-7. Questo pool di memoria raggiunge così i 128 GB, permettendo teoricamente di eseguire modelli fino a 200 miliardi di parametri. Questa configurazione è particolarmente allettante per un team che desidera acquisire inizialmente una macchina e poi espandere la propria capacità gradualmente. Tuttavia, tale setup deve sempre essere confrontato con un sistema integrato da 128 GB: distribuire un modello introduce comunicazioni tra i case, complessità software e potenziali limiti a seconda delle architetture supportate.
Prestazioni e Ecosistema Operativo
Nvidia annuncia che, in un test eseguito con Qwen 3.8 27B, le due unità collegate raggiungono il doppio della larghezza di banda e fino al 1,7 volte le prestazioni rispetto a un'unità singola. Come sempre, si tratta di risultati forniti dal costruttore che descrivono uno scenario molto preciso; le performance finali varieranno in base alla quantizzazione, alla lunghezza del contesto, al numero di utenti e al motore di inferenza utilizzato. I test indipendenti dovranno misurare parametri come il throughput dei token, la latenza al primo token, il consumo energetico e la stabilità su sessioni prolungate.
Il valore del DGX Spark risiede tanto nel suo ecosistema quanto nella sua scheda tecnica. Nvidia fornisce un stack completo che comprende CUDA, strumenti per i modelli Nemotron, Ollama, vLLM e PyTorch, oltre a un assistente dedicato alla creazione di cluster. Per un piccolo team, guadagnare diversi giorni di integrazione grazie all'ecosistema può giustificare parte del costo iniziale. È importante notare che mentre un assemblaggio meno costoso basato su componenti consumer potrebbe offrire maggiori prestazioni grezze, questo approccio richiede maggiore configurazione, manutenzione e comporta compromessi sulla memoria totale.
I Benefici della Lavorazione Locale
L'elaborazione locale risponde a tre bisogni fondamentali per le aziende di ricerca e sviluppo. Il primo è la riservatezza: documenti, codice o dati sensibili rimangono completamente all'interno dell'organizzazione. In secondo luogo c'è la prevedibilità: una macchina acquistata non fattura ogni token, garantendo funzionamento anche quando il servizio remoto subisce variazioni o interruzioni. Infine, è l'accesso all'esperimento a basso livello, con possibilità di maneggiare direttamente il modello, i pesi e l'infrastruttura sottostante.
Questi benefici devono però essere bilanciati rispetto ai costi operativi che includono elettricità, amministrazione e rinnovo hardware. A $4.999, l'acquisto non significa "economico". Due unità superano di gran lunga i costi di molte workstation e si avvicinano al prezzo di un'infrastruttura cloud; pertanto, è necessario confrontare tale investimento con il costo dell'affitto GPU nel cloud per valutare quale sia più conveniente. Un team con carichi variabili potrebbe preferire l'affitto della capacità, mentre un altro che maneggia quotidianamente dati sensibili o opera offline può ammortizzare il costo dell'hardware locale. Il calcolo deve considerare prioritariamente il tasso di utilizzo effettivo e non solo il prezzo d'acquisto.
Infine, sebbene la versione 64 GB risponda alla crescente pressione sulla memoria nell'ecosistema IA, risolvendo parzialmente la scarsità di configurazioni ad alta capacità e basso costo, Nvidia mantiene un stretto controllo sull'hardware e sullo stack software proposto. Il successo futuro dipenderà dalla reale facilità con cui le unità collegate potranno essere utilizzate, superando le dimostrazioni ottimizzate per alcune nicchie di utenza.
Il DGX Spark 64 Go è dunque meglio descritto come una riduzione della barriera d'ingresso che come una vera democratizzazione dell'IA locale. Consente ai team di entrare nello stack Nvidia con minori risorse e sviluppare la capacità in modo modulare. La sua rilevanza massima sarà per quei gruppi che hanno una comprensione precisa dei modelli da eseguire, con quale frequenza e perché l'affidamento esclusivo al cloud non è fattibile. Per tutti gli altri, il prezzo d'acquisto elevato e la complessità del collegamento rischiano di trasformare la promessa di sovranità locale in un hardware potente ma sottoutilizzato.
Prima dell'acquisto, sarà fondamentale testare il modello target su 64 GB, calcolare un anno stimato di utilizzo ed effettuare un confronto dettagliato tra due Spark collegati a una macchina da 128 GB e le opzioni cloud: la scelta migliore dipende strettamente dal tasso d’utilizzo previsto, non dallo slogan generale "IA locale".